Wenn es darum geht, die Sortierung von Kundenanfragen zu automatisieren, kommt nicht dieselbe Technologie zum Einsatz wie bei der Erstellung von Produktblättern oder der Vorhersage eines Maschinenfehlers. Jede Familie von künstlicher Intelligenz beantwortet ein spezifisches operatives Problem, und die Verwechslung ihrer Bereiche kostet Zeit und Budget.
Den richtigen Typ KI je nach zu lösendem Geschäftsproblem wählen
Die erste Frage, die man sich stellen sollte, ist nicht “Welche KI ist die leistungsfähigste?”, sondern “Welchen Prozess möchten wir verbessern?”. Ein Logistikdienstleister, der Lagerengpässe reduzieren möchte, benötigt prädiktive KI, die historische Daten nutzen kann. Ein Marketingteam, das wöchentlich Dutzende von Produktbeschreibungen erstellt, wird sich auf generative KI konzentrieren. Ein Supportzentrum, das komplexe Anfragen autonom bearbeitet, wird sich der agentischen KI zuwenden.
Dieses Prinzip findet sich in der Art und Weise, wie das Insee die Anwendungen von KI in Unternehmen unterteilt: Anstatt von großen theoretischen Familien zu sprechen, unterscheidet das Institut acht konkrete Technologien (Text Mining, Spracherkennung, Inhaltserzeugung, maschinelles Lernen, Entscheidungsunterstützung und andere). Diese funktionale Betrachtungsweise ist weitaus nützlicher als eine akademische Klassifizierung, wenn es darum geht, eine Investition zu bewerten.
Um die verschiedenen Arten von KI aus der Perspektive ihrer technischen Spezifikationen zu erkunden, bleibt dieser Rahmen nach operativem Bedarf der verlässlichste Ausgangspunkt.
Prädiktive KI und maschinelles Lernen: Antizipieren statt Reagieren
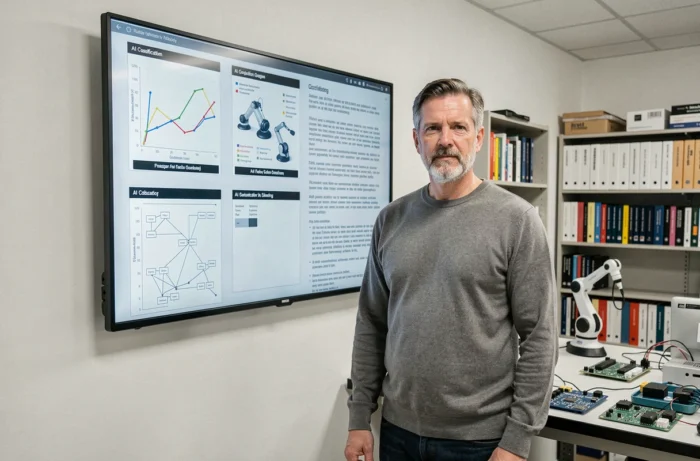
Im praktischen Einsatz bleibt maschinelles Lernen die am weitesten verbreitete Technologie. Ihr Prinzip: Ein Modell wird mit strukturierten Daten (Verkaufszahlen, Sensordaten, Produktionsprotokollen) gefüttert, und es lernt, wiederkehrende Muster zu erkennen, um vorherzusagen, was passieren wird.
Die am besten dokumentierten Anwendungsfälle drehen sich um industrielle Wartung, Betrugserkennung im Finanzwesen und Nachfrageprognosen in der Logistik. In jedem dieser Szenarien identifiziert das Modell schwache Signale, bevor ein Problem auftritt.
Deep Learning geht noch einen Schritt weiter, indem es unstrukturierte Daten verarbeitet: Bilder, Töne, freie Texte. Man findet es in der visuellen Erkennung von Fehlern an einer Produktionslinie oder in der automatischen Analyse von Vertragsdokumenten. Der Unterschied zum klassischen maschinellen Lernen liegt in der Tiefe des neuronalen Netzwerks und dem Volumen an Daten, das erforderlich ist, um es zu trainieren.
Konkrete Grenzen, die zu beachten sind
- Ein prädiktives Modell ist nur dann zuverlässig, wenn die Trainingsdaten die aktuelle Realität des Prozesses widerspiegeln. Ein Wechsel des Lieferanten oder der Saisonalität kann die Ergebnisse ohne Vorwarnung verschlechtern.
- Deep Learning erfordert Rechenleistung und Datenvolumen, die nicht alle Unternehmen mobilisieren können. Für ein KMU deckt ein gut kalibriertes klassisches maschinelles Lernmodell oft den Bedarf ab.
- Die Rückmeldungen variieren hinsichtlich der Dauer der Entwicklung: Zwischen dem funktionalen Prototyp und dem stabilisierten Modell in der Produktion hängt der Zeitraum stark von der Qualität der verfügbaren Daten ab.
Generative KI: Inhalte in großem Maßstab produzieren
Generative KI erstellt neue Inhalte (Text, Bild, Code) auf der Grundlage von Sprachmodellen, die auf umfangreichen Korpora trainiert wurden. Dies ist die Technologie hinter Schreibassistenten, visuellen Generatoren und Code-Vervollständigungswerkzeugen.
In Unternehmen sieht man sie vor allem in drei Bereichen: der Texterstellung für den Kundenservice und das Marketing, der Erstellung von Zusammenfassungen aus internen Dokumenten und der Unterstützung bei der Softwareentwicklung. Das Insee bestätigt, dass die Texterstellung und Spracherzeugung zu den am häufigsten von französischen Unternehmen gemeldeten KI-Anwendungen gehört, was einen klaren Trend zu Sprachtechnologien markiert.
Die Hauptgrenze bleibt die Kontrolle der Ausgabe. Ein generatives Modell kann plausible, aber falsche Informationen produzieren. In einem Prozess, in dem die Zuverlässigkeit der Daten entscheidend ist (regulatorisch, medizinisch, finanziell), ist eine systematische menschliche Überprüfung unerlässlich.
Agentische KI: Vollständige Prozesse delegieren
Agentische KI stellt eine zusätzliche Stufe dar. Während generative KI Inhalte auf Anfrage produziert, kann ein KI-Agent reasoning, eine Aktionssequenz planen und diese autonom ausführen. Man wechselt von der punktuellen Antwort zur Verwaltung eines End-to-End-Prozesses.
Die fortschrittlichsten Anwendungsfälle betreffen die automatisierte Bearbeitung von Schadensfällen in der Versicherung, die dynamische Optimierung von Beständen in einer Lieferkette oder die Lösung komplexer Support-Tickets ohne menschliches Eingreifen. Der Agent zerlegt das Problem, befragt mehrere Datenquellen, trifft Zwischenentscheidungen und liefert ein Endergebnis.
Was einen Agenten von einem einfachen Chatbot unterscheidet
Ein generativer Chatbot beantwortet eine Frage. Ein KI-Agent orchestriert mehrere Schritte, um ein definiertes Ziel zu erreichen. Zum Beispiel kann ein Rekrutierungsagent einen Pool von Kandidaten analysieren, die Profile mit den Kriterien der Stelle abgleichen, eine personalisierte Nachricht vorformulieren und die Interviews planen, während ein Chatbot sich damit begnügen würde, eine Frage zum Status einer Bewerbung zu beantworten.
Diese Autonomie wirft Fragen zur Governance auf: Wer validiert die Zwischenentscheidungen, wie wird das Denken des Agenten auditiert, welche Sicherheitsvorkehrungen werden getroffen. Bei Prozessen mit hohen Einsätzen behalten die meisten aktuellen Implementierungen eine menschliche Validierung in kritischen Phasen bei.
Auswahlkriterien zwischen prädiktiver, generativer und agentischer KI
Anstatt einer theoretischen Matrix kann man über drei praktische Fragen nachdenken:
- Der Bedarf bezieht sich auf die Antizipation eines zukünftigen Ereignisses (Ausfall, Betrug, Nachfragespitze): Ausrichtung auf maschinelles Lernen oder Deep Learning, je nach Art der Daten.
- Der Bedarf bezieht sich auf die Erstellung von Inhalten oder die Unterstützung beim Schreiben, Programmieren, Zusammenfassen: Ausrichtung auf generative KI, mit einem Validierungsprozess, der dem Risiko angemessen ist.
- Der Bedarf bezieht sich auf die Automatisierung eines vollständigen Prozesses, der mehrere aufeinanderfolgende Entscheidungen umfasst: Ausrichtung auf agentische KI, mit klarer Governance über die menschlichen Kontrollpunkte.
Diese drei Familien schließen sich nicht gegenseitig aus. Ein System kann ein prädiktives Modell zur Erkennung einer Anomalie, ein generatives Modul zur Erstellung des Vorfallsberichts und einen Agenten zur Einleitung des Korrekturverfahrens kombinieren. Der Wert liegt in der Verknüpfung dieser Bausteine, nicht in der Wahl eines einzelnen.
Die häufigste Falle besteht darin, von der Technologie auszugehen, anstatt vom Problem. Man wählt ein generatives Werkzeug, weil es in den Medien präsent ist, während der echte Engpass des Prozesses eine prädiktive Analyse erfordert. Zurück zum Geschäftsbedarf, bevor man das technische Bauteil auswählt, vermeidet diese Art von Diskrepanz.